Chapter 0 — Token, Kontekst Oynasi va Sampling (temperature, top-p)
LLM matnni qanday bo‘laklarga (token) bo‘lishi, kontekst oynasi nima ekanligi va sampling parametrlari (temperature, top-p) orqali modelni barqaror boshqarish sirlari.
Prompt yozishni o‘rganishdan oldin, Katta Til Modeli (LLM) inson tilini qanday "ko‘rishi" va so‘zlarni qanday generatsiya qilishining fizik mexanikasini tushunish shart. Ushbu bob keyingi barcha ilg‘or promptlash texnikalarining poydevoridir: nega promptlar uzunligi cheklangan, nega model har safar bir xil savolga har xil javob berishi mumkin va qanday qilib uni 100% barqaror boshqarish mumkin — barchasi shu yerda ochib beriladi.
Bu fundamental tamoyillar ChatGPT, Claude, DeepSeek, Gemini — barcha zamonaviy AI modellariga bab-baravar tegishlidir.
1. Token nima va Model Matnni Qanday "Ko‘radi"?
Simple Explanation (Sodda Tushuntirish)
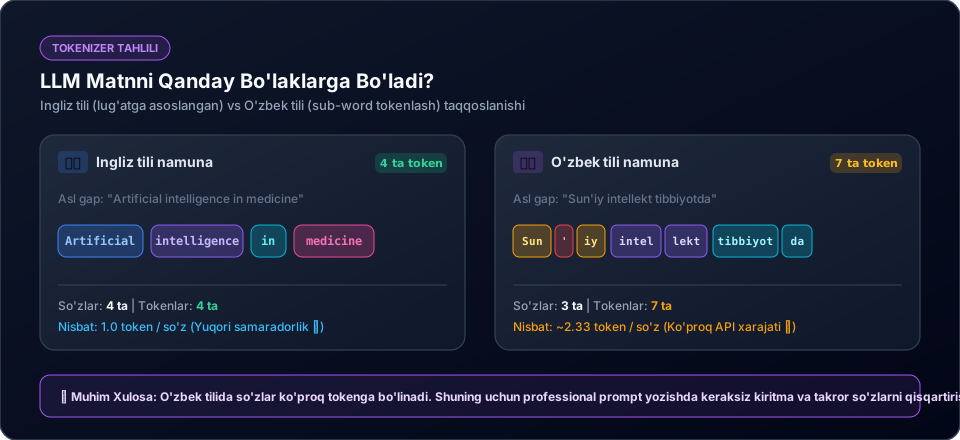
Sun’iy intellekt matnni inson kabi harflar yoki butun so‘zlar sifatida o‘qimaydi. U matnni token deb ataluvchi maxsus raqamli bo‘laklarga ajratadi.
Token — bu bitta to‘liq so‘z, so‘zning bir bo‘lagi, tinish belgisi yoki hatto bitta bo‘sh joy (probel) bo‘lishi mumkin. Model siz yozgan promptni ham, o‘zi qaytaradigan javobni ham xuddi zanjirdek tokenma-token ketma-ketlikda hosil qiladi.
Why Does It Exist? (Nega u mavjud?)
Neyron tarmoqlar matnni to‘g‘ridan-to‘g‘ri tushunmaydi — ular faqat sonlar va matematik vektorlar bilan ishlaydi. Tokenizatsiya — bu inson tilidagi harflarni kompyuter tushunadigan raqamlar matritsasiga aylantirishning xalqaro standart usulidir.
Shuningdek, token:
- API narxlash birligi: Barcha AI provayderlar (OpenAI, Anthropic, Google) har 1 000 yoki 1 million token uchun haq oladi.
- Hisoblash tezligi va xotira o‘lchovi: Modelning generatsiya tezligi bevosita soniyasiga qancha token chiqarishiga bog‘liq.
Ingliz tili va O‘zbek tili Tokenizatsiyasidagi Farq
| Til | Gap Namunasi | So‘zlar Soni | Tokenlar Soni | Samaradorlik Koeffitsiyenti |
|---|---|---|---|---|
| 🇬🇧 Ingliz tili | "Prompt engineering for developers" | 4 ta | 4 ta | 1.0 (Optimal) |
| 🇷🇺 Rus tili | "Инженерия промптов для разработчиков" | 4 ta | 9 ta | ~2.2x |
| 🇺🇿 O‘zbek tili (Lotin) | "Dasturchilar uchun prompt injiniringi" | 4 ta | 10-11 ta | ~2.5x (Qimmatroq) |
⚠️ Common Mistake (Keng Tarqalgan Xato): "1 token = 1 so‘z" deb hisoblash. Ingliz tilida o‘rtacha 1 token ≈ 0.75 so‘zga teng. Biroq o‘zbek tili kabi agglyutinativ (qo‘shimchalar orqali yasaladigan) tillarda bitta so‘z ko‘pincha 3-4 ta tokenga bo‘linadi (masalan: "kitobxonlarimiznikidan" so‘zi 5 ta alohida tokenga ajraladi). Shuning uchun o‘zbek tilida yozilgan uzun promptlar inglizchasiga qaraganda 2–3 baravar ko‘proq token sarflaydi.
📝 Practice Exercises (Amaliy Mashqlar)
🟢 Exercise 1 — Easy
Vazifa: Quyidagi jumlani ko‘rib chiqing: "Sun'iy intellekt tibbiyotda shifokorlarga tashxis qo‘yishda ko‘maklashadi." Ushbu jumlani AI modeliga yuborib, nega o‘zbek tilidagi bu gap ingliz tilidagi variantiga qaraganda 2 barobar ko‘proq tokenga bo‘linishini so‘rovchi aniq prompt yozing.
Ushbu darslik sizga yoqdimi?
Dars sifati va mazmunini yaxshilash uchun o‘z haqqoniy bahoingizni qoldiring.
Tegishli Manbalar va Amaliyot
Mavzuni to‘liq o‘zlashtirish uchun test sinovi, amaliy kodlash va bog‘liq darslar
Chapter 0 — Token, Kontekst Oynasi va Sampling (temperature, top-p)
O‘z bilimingizni interaktiv test savollari orqali tekshiring va darhol xatolarni tahlil qiling.
Exercise 1 — Easy
Nazariyani real kod yozish bilan mustahkamlang, avtomatik testlardan o‘ting va XP to‘plang.
Kurs bo‘yicha keyingi va bog‘liq mavzular: